
Datasets:

annotations_creators: []
language:
  - en
language_creators: []
license: apache-2.0
multilinguality:
  - monolingual
pretty_name: adaption-legalbrain_indic_legal
size_categories:
  - 10K<n<100K
source_datasets:
  - >-
    extended|https://huggingface.co/datasets/Prarabdha/indian-legal-supervised-fine-tuning-data
tags:
  - adaption
  - legal
  - indian-law
  - legal-ai
  - instruction-tuning
  - llm
  - question-answering
task_categories:
  - question-answering
  - text-generation
task_ids:
  - open-domain-qa
  - text2text-generation

Adaption LegalBrain Indic Legal
Adaption LegalBrain Indic Legal is a professionally remastered version of the original Indian Legal Supervised Fine-Tuning Dataset. The dataset has been enhanced using Adaption's Adaptive Data Platform, improving instruction quality, consistency, and training effectiveness for Legal AI applications.
Original Dataset: https://huggingface.co/datasets/Prarabdha/indian-legal-supervised-fine-tuning-data
Overview
This dataset contains high-quality instruction-response pairs covering Indian legal concepts, constitutional law, criminal law, contract law, corporate law, procedural law, and related judicial topics.
It is designed for:
- Legal Question Answering
- Supervised Fine-Tuning (SFT)
- Legal Chatbots
- AI Legal Assistants
- Retrieval-Augmented Generation (RAG)
- Legal Reasoning Systems
- Instruction-Tuned Large Language Models
The dataset has been automatically optimized using Adaption's Adaptive Data pipeline, resulting in improved prompt quality, reduced redundancy, and better instructional consistency.
Dataset Statistics
| Property | Value |
|---|---|
| Dataset Type | Instruction Tuning |
| Total Samples | 32,105 |
| Language | English |
| Domain | Indian Legal AI |
| Quality Grade | B |
| Relative Quality Improvement | 78.0% |
Domain Distribution
- Legal — 92%
- Corporate & Business — 4%
- Religion — 2%
Writing Style
- Informative — 44%
- Professional — 20%
- Analytical — 20%
Adaptive Data Evaluation
Quality Improvement

Grade Improvement

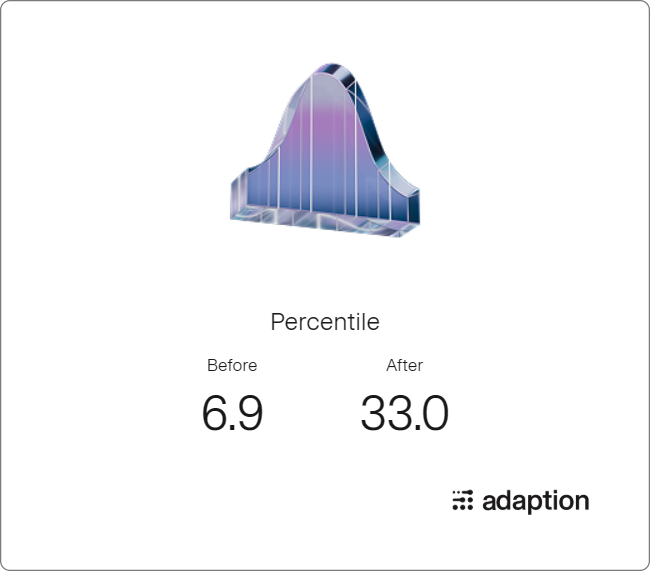
Percentile Improvement
Key Features
- High-quality legal instruction-response pairs
- Optimized using Adaption Adaptive Data
- Suitable for supervised fine-tuning
- Consistent formatting across samples
- Reduced prompt duplication
- Enhanced instruction clarity
- Ready for Legal LLM training
- Ideal for legal research assistants and AI chatbots
Recommended Use Cases
- Fine-tuning open-source LLMs
- Legal AI Assistants
- Constitutional Law QA
- Court Judgment Analysis
- Legal Education
- Legal Search Systems
- Retrieval-Augmented Generation (RAG)
- Academic Research
Credits
Dataset Publisher
Nupur Saraswat
Mastered using Adaption Adaptive Data Platform
Citation
@dataset{adaption_legalbrain_indic_legal,
  title={Adaption LegalBrain Indic Legal},
  author={Nupur Saraswat},
  year={2026},
  publisher={Hugging Face},
  note={Remastered using Adaption Adaptive Data Platform. Original dataset by Prarabdha.}
}